AGI神話の限界とポスト・スケーリングAIの未来

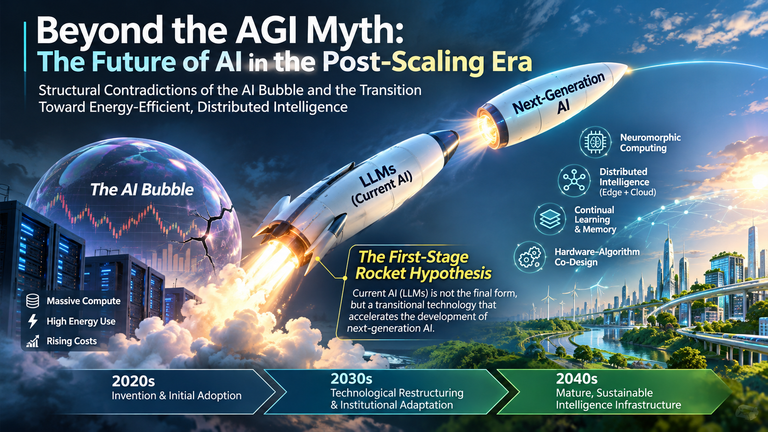
AIバブルの構造的矛盾と省エネルギー・分散型知能への技術転換 2026年11月12日 要旨 2022年のChatGPTの登場以来、人工知能は急速な発展を遂げ、2027年前後の汎用人工知能(AGI)の実現や、人間を超える超知能の出現を予測する議論が広がっている。一方、AIの急速な開発に伴うリスクを理由として、開発の一時停止や規制強化を求める主張も現れている。 しかし、こうした議論には重大な問題がある。それは、現在のAIが抱える技術的・経済的な矛盾を十分に検討しないまま、現在の技術の延長線上にAGIの実現を想定していることである。 本稿では、現在の大規模言語モデル(LLM)の発展が、依然として大規模な計算資源とデータの投入に大きく依存しており、その進歩が直ちに持続可能な汎用知能の実現を意味するものではないことを論じる。 また、現在のAIへの巨額投資は、技術的期待と経済的収益の乖離によって大規模な調整を迎える可能性があり、それは単なる金融市場の問題にとどまらず、AIの技術開発の方向そのものを変える契機となり得る。 そのうえで、現在のAIは次世代AIを実現するための過渡的な技術基盤、すなわち「第一段ロケット」であり、今後はAI自身を用いて新しい計算アーキテクチャを開発する段階へと移行するという仮説を提示する。特に、ニューロモーフィック・コンピューティング、分散型AI、継続学習、連想記憶、およびハードウェアとアルゴリズムの協調設計を有望な技術領域として検討する。 キーワード: AGI、AIバブル、スケーリング則、ニューロモーフィック、エッジAI、継続学習、AI for AI、技術パラダイム 1. はじめに――AI革命はまだ始まったばかりである…

AIバブル崩壊後はナレッジ・マイニングへシフト

はじめに AIバブルをめぐって、「AIは本物なのか、それとも偽物なのか」という議論が繰り返されている。しかし、この問いはバブルの本質を捉えていない。 2000年前後のドットコム・バブルにおいても、インターネットという技術革新そのものは本物であった。インターネットは一時的な流行として消滅したのではなく、その後、通信、商取引、広告、メディア、金融、行政など、社会のほぼすべての領域を変革した。 それにもかかわらず、ドットコム・バブルは崩壊した。 崩壊したのはインターネットではない。インターネットに関係する企業であるというだけで、実際の収益力を超えた企業価値が正当化されるという金融市場の物語であった。 AIについても、同じ区別が必要である。 現在のAIには、長期的な記憶、因果関係の理解、企業固有の状況認識、現実世界との継続的な相互作用など、依然として多くの技術的不足がある。しかし、大規模言語モデル、すなわちLLMが、自然言語による対話、文章生成、情報整理、翻訳、プログラミング支援など、人工知能の一部を確実に形にしたことは否定できない。 したがって、AIバブルが崩壊したとしても、それはAI技術が偽物であったことを意味しない。 バブルとは技術の真偽を表す言葉ではない。実在する技術革新を材料として、企業価値や株価を実際の収益力以上に膨張させ、その価格上昇から利益を得ようとするマネーゲームを意味する。 ドットコム・バブルとAIバブルに共通しているのは、技術ではなく、この金融的な構造である。 1.技術革命と金融バブルは矛盾しない 大規模な技術バブルは、存在しない技術を題材として生じるとは限らない。むしろ、社会を根本的に変える可能性を持った、本物の技術革新を題材として形成される。 誰も可能性を信じない技術では、巨額の資金を集めることはできない。ある程度の技術的成果があり、社会や産業を変える未来が想像できるからこそ、投資家は現在の収益を大幅に超えた企業価値を受け入れる。 技術革新の将来価値を正確に計算することは難しい。市場規模をどこまで拡大できるか、既存産業をどこまで置き換えるか、何年後にどの程度の利益を生むかについて、確定的な答えは存在しない。…

LLMは実務AIを構成する一つの部品となる

はじめに 大規模言語モデル(Large Language Model:LLM)の登場によって、人工知能に対する社会的認識は大きく変化した。LLMは、質問応答、文章生成、要約、翻訳、情報整理、プログラミングなど、従来は個別のソフトウェアが担っていた処理を、自然言語による単一のインターフェースから実行できる。 この能力は極めて汎用的であり、その社会的影響も大きい。そのため、現在では「AIとはLLMである」「AIの発展とはTransformerをさらに高度化・大規模化することである」という理解が広がりつつある。 しかし、自然な対話ができることと、現実の業務を継続的かつ安定的に遂行できることは同一ではない。 LLMは、言語、一般知識、パターン認識を扱う強力な基盤技術である。一方、実際の仕事には、長期記憶、組織固有の概念、判断基準、因果関係の理解、計画、実行、結果評価、業務システムとの接続など、言語生成とは異なる機能が必要となる。 したがって、本稿では次の命題を提示する。 LLMは実務AIそのものではなく、将来の実務AIを構成する重要な一つの部品となる。 実務AIの実現には、LLMを中心としながらも、異なる原理を持つ複数の要素技術を統合した認知システムが必要である。 1.対話能力と実務遂行能力の区別 LLMの能力を評価する際には、対話能力と実務遂行能力を区別する必要がある。 対話能力とは、与えられた入力に対して、文脈に適合した応答を生成する能力である。現在のLLMは、この点において極めて高い性能を示している。 これに対して実務遂行能力とは、一定の目的のもとで状況を把握し、必要な情報を取得し、過去の経験や規則を参照し、判断を行い、外部システムに働きかけ、その結果を記録・評価する能力である。…

RAGはなぜ初歩的なまま普及したのか

――SOMの歴史が示す「最初の教科書」の罠 生成AIを社内文書に接続する方法として、RAG(Retrieval-Augmented Generation)が広く知られるようになった。 一般に説明されているRAGの仕組みは、驚くほど単純である。 LangChainの公式入門も、文書、テキスト分割、埋め込み、ベクトルストア、Retrieverをセマンティック検索の基本構成として説明している。RAG研究の代表的なサーベイでも、この「文書をチャンク化し、ベクトルDBに保存し、質問との類似度で上位のチャンクを取得する」方式は、明確にNaive RAGと分類されている。 問題は、この方式が入門用の基本モデルとして紹介されていることではない。 入門用のモデルが、あたかもRAGの完成形であるかのように受け止められていることである。 質問と回答文を直接比較する不自然さ そもそも、ユーザーが入力する質問文と、文書に記載されている回答文は、言語的に異なる形式を持っている。 例えば、契約書に次のように書かれているとする。 契約期間満了日の30日前までに書面による通知がない場合、契約は自動的に更新される。 利用者はこれを、次のように質問するかもしれない。 自動更新を止めるには、いつまでに連絡すればよいですか。…

AIを信頼できるパートナーにするために

LLMに欠けている「エピソード記憶」 現在の生成AIは、文章の作成、情報の整理、プログラミング、調査、業務の自動化など、さまざまな作業を高い水準でこなせるようになりました。その能力だけを見れば、AIに仕事を任せ、人間は結果だけを確認すればよい時代が近づいているようにも見えます。 しかし、現在のAIには、人間なら当然持っている重要な能力が欠けています。 それは、過去の経験を記憶し、目の前の状況に関係する出来事を思い出し、その経験を現在の判断に反映する能力です。 この問題を理解すると、現在のAIに長期的な仕事や重要な判断をそのまま任せることが、なぜ危険なのかが見えてきます。 AIは「最初に決めたこと」さえ保持できない YouTube動画「【世界初】AIが人間のように考えていないことを実証。あなた…」では、AIを相手に「20の質問」に似た実験が行われています。 AIに最初に何か一つの答えを決めさせ、人間が質問を重ねながらその答えを当てようとします。ところが会話が進むにつれて、AIが最初に決めたはずの対象が、いつの間にか別のものへと変化してしまいます。AIはその変化を明確に自覚せず、あたかも最初から同じ答えを考えていたかのように、その時点の会話に合う説明を生成します。 これは、AIが嘘をつこうとしているからではありません。 LLMは、人間のように心の中で答えを保持しながら会話しているわけではなく、その都度、与えられた文脈から次に続くもっともらしい文章を生成しています。 厳密には、LLMにも処理中の内部状態やコンテキストウィンドウがあります。そのため、現在表示されている会話や指示を一時的に参照することはできます。しかし、モデル単体が会話をまたいで出来事を保存し、必要なときに自律的に思い出しているわけではありません。 一般にAIアプリケーションで「AIが会話を覚えている」ように見えるのは、アプリケーション側が過去の会話、要約、ユーザー情報などを保存し、それらを次の問い合わせと一緒にLLMへ渡しているからです。 長い仕事には「作業メモ」が必要になる 現在のAIを比較的安定して使う方法の一つは、一連の作業の間に覚えておくべき情報を、明示的なメモとして書き出させることです。…

記号主義とコネクショニズム

AIは「世界の構造」を記述するのではなく、「概念」を生成しなければならない 人工知能研究の歴史は、大きく分ければ二つの考え方の対立として捉えることができる。 一つは、知識を記号として表現し、論理規則によって操作しようとする記号主義である。もう一つは、多数の単純な処理単位の結合と学習によって知的機能を実現しようとするコネクショニズムである。 現在の生成AIは、ニューラルネットワークを基盤とするという意味ではコネクショニズムの勝利に見える。しかし、実際のAIシステムを構築する段階では、データベース、オブジェクト、クラス、知識グラフ、オントロジーなど、記号主義的な枠組みが依然として広く使われている。 問題は、どちらが正しいかではない。 より根本的な問題は、記号処理の前提となる「概念」が、どのように生じるのかである。 AI研究を支配した二つの潮流 初期のAI研究では、人間の知能は記号を操作する能力として理解された。 ニューウェルとサイモンが提示した「物理記号システム仮説」は、適切な記号と操作規則を持つ物理システムには、知的行動を実現するための必要十分な能力があると主張した。問題解決、定理証明、ゲーム、自然言語理解などを、記号の探索と変換として実現しようとしたのである。 この立場では、世界には「人間」「企業」「商品」「契約」「原因」「目的」といった対象や関係があり、それらを適切な記号に置き換えれば、コンピュータも人間と同様に推論できると考える。 しかし、現実の世界に関するあらゆる知識を、あらかじめ記号と規則に変換することは難しかった。例外や文脈依存性が増えるほど規則は複雑化し、知識ベースの構築と保守に膨大な労力が必要になる。 これに対してコネクショニズムは、知能を明示的な規則の集合としてではなく、多数の処理単位間の結合状態として捉える。人工ニューラルネットワークは、学習データから結合の重みを変化させ、入力と出力の関係を獲得する。コネクショニズムは1980年代に再興し、現在の深層学習と大規模言語モデルへとつながった。 記号主義が「知識を人間が記述する」アプローチであるのに対し、コネクショニズムは「データから内部表現を学習する」アプローチだと言える。 オブジェクト指向は世界そのものではない…